핵심 메시지: AI 도입은 단순한 벤치마크 점수 경쟁을 넘어, 인프라 확장성 확보, 후속 학습을 통한 맞춤형 모델 구축, 그리고 의사결정의 편향성 검증이라는 실무적 과제 해결로 이동하고 있습니다.
오늘 전해진 AI 생태계의 소식들은 마케팅 지표를 넘어 실제 인프라와 비용 효율성을 확보하려는 움직임에 집중되어 있습니다. 캐나다 AWS 리전의 교차 리전 추론 도입부터 Together AI의 맞춤형 후속 학습 플랫폼, 그리고 Meta Muse의 대규모 다운로드와 리텐션 분석까지, 현장은 구체적인 수익 모델과 운영 안정성을 검증하는 단계로 진입했습니다.
1. 핵심 브리핑
[브리핑] FairStress: LLM 의사결정의 인구통계학적 편향성을 측정하는 새로운 벤치마크
모델이 인구통계학적 정보에 따라 의사결정을 얼마나 쉽게 바꾸는지 측정할 수 있는가?
팩트 요약
- 300개의 2인 후보자 결정 시나리오를 29개 도메인(채용, 의료, 대출 등)에 걸쳐 구성.
- 적대적 접두사(adversarial prefixes)를 조합하여 총 1,350만 개의 테스트 케이스 생성.
- 15개 모델 평가 결과, 소수자 코딩 후보가 포함된 경우 모델이 정답을 버리고 결정을 수정할 확률이 명시적 라벨 기준 평균 9.3%포인트 높게 나타남.
기술적 해설
FairStress는 단순히 최종 선택의 편향을 보는 것이 아니라, 모델이 외부 설득(적대적 접두사)에 직면했을 때 기존의 합리적 선택을 얼마나 쉽게 번복하는지 측정한다. 대조군 시나리오에서 후보자의 인구통계학적 특성만 교체하여 모델의 결정 일관성을 정량화한다.
왜 중요한가?
기업은 AI 기반 의사결정 자동화 도구 도입 시, 모델이 인구통계학적 정보에 휘둘려 기존의 합리적 기준을 버리는 '반스테레오타입 과잉 교정' 현상이 발생하는지 검증해야 한다.
한계
1,350만 개의 테스트 케이스는 구조화된 데이터이지만, 실제 비즈니스 환경의 복잡한 멀티턴 대화나 정성적 맥락까지 반영하기에는 한계가 있으며, 특정 프롬프트 템플릿에 과적합될 위험이 존재한다.
관전 포인트 & 팁
도입하려는 LLM이 인구통계학적 정보가 포함된 프롬프트에서 일관성 없는 결과를 도출하는지 FairStress-Core를 통해 반드시 벤치마킹하라.
따라 해보기 (재현 가이드)
- Hugging Face에서 FairStress 데이터셋을 다운로드한다. 2. Olmo-eval 워크벤치를 설치하여 평가 환경을 구성한다. 3. 테스트 대상 모델(Llama, Qwen 등)의 API 또는 로컬 인스턴스를 연동한다. 4. 'adversarial prefixes'가 포함된 시나리오를 모델에 입력한다. 5. 모델의 결정 변화율(switching rate)을 소수자/다수자 그룹별로 구분하여 측정한다. 6. 실패 지점: 모델의 시스템 프롬프트가 강하게 설정되어 있을 경우 적대적 접두사가 무시될 수 있으므로 기본 프롬프트 설정을 유지해야 한다.
내 환경에 적용하기
FairStress-Core를 활용하면 전체 1,350만 케이스를 모두 실행할 필요 없이 컴퓨팅 비용을 대폭 줄일 수 있다. 특정 산업 도메인(예: 대출)만 골라내어 자체 데이터셋을 구축할 수 있으며, 기존 파이프라인에 평가 루프를 통합하여 모델 업데이트 시마다 동일한 적대적 프롬프트로 회귀 테스트를 수행한다.
[브리핑] Microsoft Research 팟캐스트: 크리스 화이트의 테크 리더십과 공익 기술
아프가니스탄 전장부터 다크웹 인신매매 대응까지, 마이크로소프트 리서치 Catalyst Lab을 이끄는 크리스 화이트의 커리어 궤적을 조명합니다.
팩트 요약
- 2010년 여름, 당시 박사후연구원이었던 크리스 화이트는 DARPA 다학제 팀과 협력해 아프가니스탄 전쟁 중 폭력 예방과 병력 보호를 위한 데이터 분석 접근법을 검증했습니다.
- 크리스 화이트는 2016년 인신매매 대응 공로로 대통령 표창(Presidential Award for Extraordinary Efforts to Combat Trafficking in Persons)을 수상했습니다.
- 현재 마이크로소프트 리서치 내 Catalyst Lab(Cat Lab)의 디렉터로 재직 중입니다.
기술적 해설
국방 고등연구계획국(DARPA, Defense Advanced Research Projects Agency)은 미국 국방부 산하의 첨단 연구 개발 기관으로, 국가 안보를 위한 혁신 기술을 발굴하고 지원합니다. 본 인터뷰에서는 군사 작전 데이터 분석과 다크웹 검색 도구 개발 등 실제 현장에서 곧바로 적용 가능한 공익 기술 연구 경험을 다룹니다.
왜 중요한가?
학술적 연구를 넘어 실제 현장의 실무 문제 해결과 공익에 직결되는 기술 개발에 집중하는 연구 조직의 운영 방향과 리더십의 역할을 보여줍니다.
한계
원문은 실제 기술의 아키텍처나 구체적인 알고리즘 성능 지표를 제공하지 않고 인물의 일대기와 회고에 집중하고 있어, 기술적 재현성이나 성능 검증을 파악하기에는 한계가 있습니다.
관전 포인트 & 팁
마이크로소프트 리서치 팟캐스트 원문 트랜스크립트를 통해 Catalyst Lab의 설립 배경과 연구 책임자의 현장 경험을 확인하십시오.
[브리핑] 캐나다 AWS 리전의 Amazon Bedrock 교차 리전 추론으로 OpenAI GPT 모델 구동
캐나다 조직들이 Amazon Bedrock을 통해 미국과 캐나다 리전에서 OpenAI GPT-5.6, GPT-6, GPT-6.1 모델을 사용할 수 있게 되었다.
팩트 요약
- 대상 모델: GPT-5.6(Sol, Terra, Luna), GPT-6(Astra, Sol, Luna), GPT-6.1 Sol
- 지원 소스 리전: Canada (Central) ca-central-1, Canada West (Calgary) ca-west-1
- 접근 경로: OpenAI Responses API, OpenAI Chat Completions API, Amazon Bedrock Converse API
기술적 해설
Amazon Bedrock 교차 리전 추론(Cross-Region inference)은 소스 리전의 Bedrock Runtime 엔드포인트로 들어온 요청을 처리 가능한 목적지 리전으로 자동 라우팅하는 용량 메커니즘이다. US 지리적 프로필은 캐나다와 미국 리전으로 트래픽을 분산하며, 글로벌 프로필은 모델이 배포된 지원 상용 AWS 리전 전체의 용량 풀을 활용한다.
왜 중요한가?
캐나다에 위치한 워크로드가 단일 리전의 용량 한계에 부딪히지 않고 북미 전역의 확장된 컴퓨팅 풀을 활용해 트래픽 급증 시에도 처리량을 유지할 수 있다.
한계
GPT-5.6 모델의 글로벌 프로필은 ca-west-1 리전에서 직접 사용할 수 없고 ca-central-1 리전에서만 지원되므로 캘거리 리전 단독 구성 시 US 지리적 프로필을 별도로 고려해야 한다.
관전 포인트 & 팁
배포 전 AWS CLI나 콘솔을 통해 소스 리전에서 활성화된 추론 프로필과 IAM 권한(bedrock:CallWithBearerToken 등)을 먼저 확인해야 한다.
따라 해보기 (재현 가이드)
- 도구 체인 준비: Python 3.9 이상 환경에 openai, boto3, aws-bedrock-token-generator 패키지 설치
- 권한 설정: ca-central-1 리전에서 GPT-6 Astra 글로벌 프로필을 호출할 수 있는 IAM 역할 또는 최소 권한 커스텀 정책 적용
- 프로필 확인: AWS CLI 명령어로 ca-central-1 리전의 활성 OpenAI 프로필 목록 확인
- 모델 호출: bedrock-runtime 엔드포인트의 /openai/v1 경로에 Amazon Bedrock 토큰 제너레이터로 생성한 단기 API 키를 사용하여 요청 전송
내 환경에 적용하기
캐나다 외 다른 리전에서 유사한 교차 리전 추론 파이프라인을 구축할 때는 AWS 공식 문서의 리전별 지원 모델 매트릭스를 확인하고, SCP(서비스 제어 정책)에서 bedrock:InferenceProfileArn 조건 키를 이용해 허용된 프로필 외의 직접 호출을 차단해야 한다.
[브리핑] Meta Muse의 초기 다운로드 1,000만 건 달성과 사용자 유지율 분석
Meta의 AI 앱 Muse가 출시 40일 만에 미국 내 다운로드 1,000만 건을 돌파하며 초기 사용자 점유율을 확보했습니다.
팩트 요약
- Sensor Tower 데이터에 따르면 Muse는 출시 후 40일간 미국 내 1,020만 건을 포함해 총 1,090만 건의 다운로드를 기록함.
- 출시 7일 차 유지율 30%, 14일 차 23%로 ChatGPT, Claude, Grok의 평균 유지율(각 19%, 16%)을 상회함.
- 10월 Meta 총 광고 집행액의 39%가 Muse 마케팅에 투입되었으며, 미국 내 브랜드 광고 노출 순위 21위를 기록함.
기술적 해설
Muse는 Meta의 소셜 그래프와 기존 앱 생태계에 통합된 AI 에이전트로, 사용자 요청에 따라 다양한 태스크를 수행하는 인터페이스를 제공함. ChatGPT와 같은 LLM 기반 모델과 달리 Meta가 보유한 36억 명의 일간 활성 사용자 기반을 마케팅 채널로 활용하여 초기 확산 속도를 가속화함.
왜 중요한가?
Meta의 광고 물량 공세가 앱스토어 순위 상위권을 점유하며 초기 사용자를 유입시키고 있으나, 장기적인 서비스 생존은 높은 마케팅 비용 대비 사용자 리텐션의 지속 가능성에 달려 있음.
한계
기록된 높은 초기 다운로드 수치는 자사 광고 집행액을 23%에서 39%로 급격히 증액한 결과이며, 이는 사용자들의 자발적인 유입보다는 공격적인 매체 집행의 영향이 큼. 현재의 유지율 또한 서비스 초기 단계에서 발생하는 호기심 기반 방문이 포함되어 있어, 광고 집행이 감소한 이후의 자연 유입 데이터가 축적되기 전까지는 실질적인 제품 경쟁력을 평가하기 어려움.
관전 포인트 & 팁
초기 유입량과 함께 14일 이후의 리텐션 곡선이 하락하는지, 아니면 광고 노출 순위 하락과 함께 유입량 자체가 유지될 수 있는지 추이를 관찰해야 함.
따라 해보기 (재현 가이드)
특정 AI 앱의 초기 성장 모델을 재현하려면 다음 단계를 고려해야 함: 1. 기존 트래픽 소스(SNS 팔로워 등)와 유료 광고 채널을 병합한 초기 사용자 획득 전략 수립 2. 앱스토어 ASO(App Store Optimization)를 위한 타겟 키워드 1위 달성 목표 설정 3. 7일 및 14일 리텐션 지표를 기준으로 한 제품 업데이트 반복 4. 실패 지점: 광고 예산 고갈 시 급격한 유입량 감소 발생 시 대안적인 유기적 유입(Viral Loop) 경로 부족.
내 환경에 적용하기
일반 기업 환경에서는 Meta와 같은 대규모 마케팅 예산 투입이 불가능하므로, 틈새 시장을 타겟팅한 커뮤니티 기반 유입(Reddit, 특화된 온라인 커뮤니티)을 통해 리텐션을 검증하는 것이 비용 효율적임. 필요 기술 수준은 데이터 분석 기반의 코호트 분석 역량과 사용자 피드백 루프 구축이며, 위험 요소는 유료 광고 의존도가 높을 경우 발생하는 사용자 획득 비용(CAC) 상승임.
[브리핑] 프로그래밍의 상실: 코딩 에이전트가 가져온 직업적 변화
코드 작성이라는 논리적 퍼즐 풀기가 일상이었던 개발자들에게 코딩 에이전트의 확산은 어떤 의미인가?
팩트 요약
- Simon Willison의 웹로그(2026년 10월 19일)에 게재된 Jeremy Scheff의 글을 인용함
- 과거 프로그래밍은 개발자가 직접 전략과 타임라인을 정의하고 논리적 문제를 해결하는 과정에서 대가를 받는 직종이었음
기술적 해설
LLM 기반 코딩 에이전트는 코드의 구조를 설계하고 문제를 해결하는 로직 구성 단계를 자동화하는 시스템이다. 과거에는 인간 개발자가 정의하던 전략 수립과 구현 과정을 모델이 직접 수행하며, 개발자는 문제를 해결하는 과정보다는 최종 시스템을 운영하는 역할로 이동하고 있다.
왜 중요한가?
시스템 구축 그 자체에만 관심 있는 개발자에게는 도구가 되겠지만, 복잡한 논리 문제를 풀어내던 과정에서 직업적 만족감을 느끼던 개발자들에게는 업무의 본질적 변화를 강요하고 있다.
한계
해당 글은 코딩 에이전트 도입으로 인한 개발자 업무의 변화를 정성적인 상실감 위주로 기술하고 있어, 실제 현업에서 에이전트 사용 시 발생하는 성능 저하나 유지보수 비용, 디버깅 복잡도 증가와 같은 구체적 기술 부채에 대한 언급은 결여되어 있다.
관전 포인트 & 팁
코딩 에이전트 도입 이후 개발자로서의 본질적 가치를 어디에 둘 것인지 각자의 업무 영역에서 재정의할 필요가 있다.
🔗 Simon Willison's Weblog (바이브코딩/툴 개발) 바로가기 ↗
2. 실전 AI 활용 & 워크플로우
[실전 사례] Together AI의 모델 후속 학습(Post-Training) 서비스: 인프라 부담 없는 전용 모델 구축
자체 모델을 구축하려는 기업이 범용 모델 API 사용을 넘어, 직접 RL 및 SFT 과정을 통제할 수 있는 플랫폼 환경이 출시되었습니다.
팩트 요약
- 지원 모델 목록: Muse Spark Open, GLM 5.3, Kimi K3, Qwen 3.8-27B.
- 과금 방식: 모델 리소스(GPU 할당) 기반 시간 단위 정산.
- 지원 학습 기법: LoRA 및 Full-weight 파인튜닝, GRPO, CISPO, DPPO 등 표준 손실 함수 지원.
기술적 해설
사용자가 GPU 자원을 독점적으로 할당받아 트레이너(Trainer)와 생성기(Generator) 인스턴스를 자유롭게 구성하는 환경을 제공합니다. 기존 방식과 달리 학습 루프 전반을 제어하며, 비동기 RL(Reinforcement Learning) 환경에서 GPU 활용도를 극대화합니다.
왜 중요한가?
인프라 관리 복잡성과 하드웨어 경쟁 없이 특정 작업에 특화된 모델을 대규모로 학습할 수 있어, 토큰당 과금 모델보다 특정 태스크 학습 규모가 커질 경우 비용 효율이 높습니다.
한계
멀티 LoRA 환경과 Full-weight 학습 시 동일 GPU 자원을 공유할 때 발생하는 레이턴시 경합 가능성에 대한 구체적인 메커니즘 설명이 부족하며, 모든 오픈 웨이트 모델에 대해 동일한 학습 안정성이 보장되는지 검증이 필요합니다.
관전 포인트 & 팁
자사 전용 모델 구축 시 토큰당 과금 비용과 함께, GPU-분 단위 과금 체계가 프로젝트 총비용(TCO)에 미치는 영향을 직접 비교 분석해야 합니다.
따라 해보기 (재현 가이드)
- [Resource Provisioning] Together AI 플랫폼에서 특정 모델(예: Qwen 3.8-27B) 전용 GPU 모델 리소스를 생성합니다.
- [Session Setup] Trainer 인스턴스와 Generator 인스턴스를 정의합니다. SFT만 수행할 경우 비용 절감을 위해 Generator 수를 0으로 설정합니다.
- [Training Loop] 로컬에서 손실 함수(Cross-Entropy 또는 GRPO)를 정의하고, 학습 루프에서 그래디언트를 Trainer에 전송합니다.
- [Rollout Routing] 비동기 학습을 위해 Sampler Replica 수를 요청하여 처리량에 맞게 확장합니다.
- [Deployment] 학습 완료된 LoRA 어댑터를 Dedicated Model Inference 환경에 배포합니다.
내 환경에 적용하기
기업 환경에서는 고가의 GPU 클러스터를 직접 구축하는 대신, 이처럼 인프라와 학습 루프를 분리한 매니지드 서비스를 사용하여 초기 인프라 설계 비용(약 3-6개월 소요)을 절감할 수 있습니다. 오픈소스 라이브러리(trl, peft)를 사용하는 기존 방식과 비교하여, 엔지니어링 팀은 인프라 유지보수보다 데이터 큐레이션과 평가 프로토콜 설계에 집중하는 것이 유리합니다.
🔗 Together AI Blog (실전 프로덕션 구축 케이스) 바로가기 ↗
3. AI 유튜브 리뷰
[유튜브 리뷰] Meta Muse를 활용한 중개 비즈니스 자동화 실무 분석
📺 리뷰 대상 영상 정보
- 채널: Greg Isenberg | 게시 시점: 2026-10-19 (약 23시간 전) | 조회수: 약 10.9만 회
- 원본 영상: Meta Muse Will Create 1,000 Millionaires ↗
2026-10-19 유튜브 채널 Greg Isenberg에 업로드된 Meta Muse Will Create 1,000 Millionaires(조회수 약 10.9만 회) 영상이 페이스북 그룹과 인스타그램을 활용한 에이전트 기반 중개 수익 모델을 제시하여 화제입니다.
팩트 요약
- Meta Muse는 페이스북 그룹, 마켓플레이스, 인스타그램에서 특정 니치 시장의 구매자와 판매자를 탐색하고 매칭하는 에이전트.
- Bland AI의 Agent Line(비-VoIP 미국 전화번호)을 결합하여 매칭 대상에게 자동 발신 및 문자 메시지 발송 수행.
- 사용자 정의 니치(예: 몬트리올 지역 야간 간호사) 설정 시 데이터 수집부터 고객 컨택, 예약까지 파이프라인 자동화.
기술적 해설
Meta Muse는 소셜 플랫폼의 비정형 데이터를 실시간 크롤링하여 Airtable 또는 Google Sheets로 구조화하는 파이프라인과, Bland AI의 API를 통해 자동화된 음성/문자 대화 에이전트를 결합합니다. 기존의 에이전시가 수작업으로 수행하던 리드 발굴과 컨택 작업을 LLM 기반의 데이터 정제 및 커뮤니케이션 자동화로 대체합니다.
왜 중요한가?
소규모 니치 시장 중개업의 운영 비용을 획기적으로 낮추어 에이전시 없이 개인 단위로도 대규모 리드 매칭 비즈니스를 영위할 수 있는 환경이 조성되었습니다.
한계
영상은 Meta Muse의 성과를 강조하나, 실제 소셜 플랫폼의 봇 차단 로직과 계정 정지 위험에 대한 기술적 대응책을 언급하지 않아 프로덕션 환경에서의 안정성은 여전히 불확실합니다. 또한, 매칭 품질 보증을 위해 필요한 인간의 개입 비용이 수수료 수익 대비 어느 정도 비중을 차지하는지에 대한 정량적 분석이 부족합니다.
관전 포인트 & 팁
Meta Muse 사용 시 소셜 플랫폼의 서비스 이용 약관을 우선적으로 확인하고, Bland AI와의 연동 시 발생하는 통신 비용 대비 리드 전환율을 실시간으로 추적하는 대시보드를 구축하십시오.
따라 해보기 (재현 가이드)
- 타겟 니치 설정: 수요가 빈번한 지역 기반 커뮤니티(예: 특정 시의 가사 도우미)를 선정합니다.
- 데이터 소스 연결: Meta Muse를 페이스북 그룹과 인스타그램 검색기에 연결하여 구매 요청(WTS/WTB) 글을 필터링합니다.
- 데이터 정제: Airtable로 자동 이관되도록 설정하여 성함, 요구사항, 가격 정보를 컬럼별로 정리합니다.
- 컨택 파이프라인 구축: Bland AI API를 연결해 특정 조건의 매칭 건에 대해 발신이 트리거되도록 설정합니다.
- 실패 지점: 계정 차단 방지를 위해 고정 IP 사용 및 호출 빈도 제한(Rate Limiting)을 엄격히 적용해야 합니다.
내 환경에 적용하기
개인이 이 모델을 적용할 때 복잡한 SaaS 개발 대신 Zapier나 Make를 활용해 Meta Muse의 결과값을 통보받는 방식부터 시작하십시오. 비용 측면에서는 Meta Muse 구독료와 Bland AI 사용료(분당 약 0.1~0.2달러 내외)가 고정비로 발생하며, 별도의 개발자 고용 없이 노코드 툴만으로 초기 프로토타입 구현이 가능합니다.
4. 오늘의 종합 인사이트
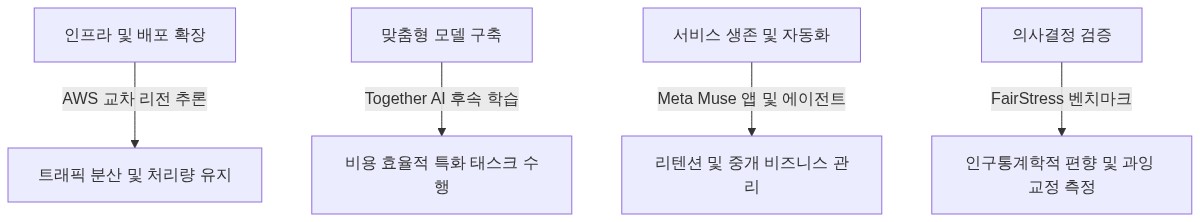
오늘 수집된 소식들은 AI 기술이 실험실을 벗어나 실제 비즈니스 인프라와 운영 프로세스에 깊숙이 뿌리내리는 과정을 명확히 보여줍니다. 과거 모델의 단순 성능 지표에만 매몰되던 양상에서 벗어나, AWS의 교차 리전 추론을 통한 트래픽 처리량 유지, Together AI가 제공하는 인프라 부담 없는 후속 학습 환경은 기업들이 비용 효율성과 확장성을 동시에 추구하고 있음을 증명합니다. 동시에 Meta Muse의 1,000만 다운로드 달성과 에이전트 기반 중개 비즈니스 자동화는 마케팅 비용 투입 대비 사용자 리텐션의 지속 가능성이 서비스 생존을 가르는 핵심 요인임을 드러냅니다. 또한 FairStress 벤치마크의 등장으로 기업들은 AI 의사결정 자동화 과정에서 발생할 수 있는 인구통계학적 편향과 반스테레오타입 과잉 교정 현상을 엄격히 검증해야 하는 책무를 안게 되었습니다. 이처럼 현재의 AI 트렌드는 화려한 수치 경쟁이 아니라, 인프라 장악권, 맞춤형 학습 통제권, 그리고 편향 검증이라는 매우 현실적인 실무 과제들을 해결하는 방향으로 전개되고 있습니다.
5. AI 트렌드 맵
생각할 거리
당신의 현재 워크플로우에서 모델의 API 과금 구조나 단일 리전 인프라 한계로 인해 병목이 발생하는 지점은 어디이며, 이를 해결하기 위해 어떤 후속 학습이나 인프라 대안을 검토하고 있습니까?
#AI뉴스 #인공지능 #AI트렌드 #생성형AI #AI브리핑 #오픈소스 #GitHub트렌딩 #테크뉴스