핵심 메시지: 모델 성능 경쟁이 끝물에 다다르자, 승부는 토큰·대역폭·엔지니어링 시간을 얼마나 아끼고 인프라를 직접 쥐느냐로 넘어갔다.
제인스트리트와 HRT가 수십억 달러로 GPU를 싹쓸이하고, 앤트로픽이 퍼스트파티 앱으로 엔터프라이즈를 잠그는 사이, 실무 현장은 AWS 프롬프트 캐싱으로 토큰 60%를 깎고, 실마릴스로 합의 대역폭을 22분의 1로 줄이며, 프록시닉스로 에이전트 재시도 비용을 3~4배 낮추는 '비용 공학'에 몰두한다. 더 이상 '더 큰 모델'이 답이 아니다. 추론·운영 비용을 구조적으로 떼어내고 인프라 주권을 확보한 팀만 살아남는다.
1. 심층 분석
[심층 분석] SILMARILS-MV: 무신뢰 키 발급·선형 집계 가능한 정보론적 다중 검증자 서명, 허가형 블록체인 합의 트래픽 22배 절감
양자 내성 서명이 합의 대역폭을 수십 배 부풀리는 지금, 신뢰할 수 있는 딜러 없이 정보론적 보안을 달성하면서 검증자 1000명 기준 블록당 인증 트래픽을 ML-DSA-44 대비 22분의 1로 줄인 SILMARILS-MV가 arXiv에 등장했다.
팩트 요약
- 2026년 10월 22일 arXiv cs.CR에 제출(Khadijeh Bagheri 박사), Rust HotStuff 프로토타입에서 검증자 100명 기준 ML-DSA-44 대비 2.8배 TPS, 암호 연산 CPU 67배 감소
- 임계값 공증 시 파이널리티 인증서 크기 32(ω+1) 바이트 상수, 검증자당 발급 비용이 n에 무관
- 인증서 검증 2.4 마이크로초, 검증자 1000명 정규 케이스 모델에서 블록당 검증자당 71 KiB 인증 트래픽(ML-DSA-44 대비 22배 감소), 몬테카를로 공격이 이론 경계와 일치
기술적 해설
서명은 벡터 α = A·e(m) 형태이며, 각 검증자는 가상 앵커 Γ에서 유도된 비밀 함수 c_i = Γ^T λ(x_i)를 보유한다. Γ는 누구도 학습하지 않는다. 키 발급은 검증자들이 브로드캐스트 없이 t < n/3 조건으로 완전 보안 MPC를 수행해 딜러 없이 이뤄진다. 강건한 재분배로 멤버십 변경과 셰어 갱신을 지원하며, 검증자는 사후 등록 가능하다. 중재자 검증 키를 쓰면 클라이언트 서명이 32바이트로 줄어든다.
심층 분석 & 비하인드 스토리
SILMARILS-MV가 지금 수면 위로 오른 배경은 명확하다. NIST PQC 표준화(ML-DSA, SLH-DSA)가 마무리되면서 허가형 블록체인 진영은 '서명 크기·검증 비용·대역폭' 삼중고를 떠안았다. ML-DSA-44 기준 서명 2420바이트, 공개키 1312바이트가 검증자 수에 비례해 합의 메시지에 중첩되니 1000명 위원회에서 블록당 수십 MB 트래픽이 일상이 됐다. 기존 정보론적 대안들은 신뢰할 수 있는 딜러(키 분배 중앙화), 양자 채널(물리 인프라 비용), 서명당 인터랙션(레이턴시), 일회용 키(전송 횟수 제한) 중 하나를 포기해야 했다. SILMARILS-MV는 이 네 가지 제약을 동시에 걷어냈다. 핵심은 '가상 앵커 Γ'다. 아무도 Γ를 모르는 상태에서 검증자 각자가 MPC로 Γ^T λ(x_i) 조각만 쥐게 하니, 딜러 없이도 정보론적 비밀 분산이 성립한다. 서명이 선형 집계 가능해 임계값 공증 시 인증서 크기가 검증자 수 n이 아닌 부패 한도 ω에만 의존한다(32(ω+1) 바이트). 이는 HotStuff·Tendermint류 BFT에서 '위원회가 위원회를 서명'하는 메타 합의 구조와 정확히 맞아떨어진다. Rust 프로토타입에서 100명 검증자 기준 2.8배 TPS, 67배 CPU 감소는 서명 검증이 행렬-벡터 곱(2.4μs)으로 끝나기 때문이다. 몬테카를로 공격이 이론 경계 Q/q + 1/(q-1)와 일치한다는 점도 구현 검증 차원에서 의미 있다. 다만 논문은 '정규 케이스 분석 모델'을 썼고, 네트워크 파티션·뷰 체인지·비동기 지연 같은 실전 합의 예외 경로는 다루지 않았다. MPC 키 발급 라운드 수와 통신 복잡도도 생략돼 있어, 실제 네트워크에서 키 갱신·멤버십 변경 시 블록 생산이 멈추는 구간이 얼마나 될지 미지수다. 라이선스 미명시·코드 미공개 상태라 상용화 검토 전 법적·공급망 리스크부터 확인해야 한다.
한계
논문은 1000명 검증자 '정규 케이스 해석 모델'에서 71 KiB/검증자/블록을 주장하나, 뷰 체인지·파티션·비동기 지연 등 비정상 경로 트래픽은 미공개다. MPC 키 발급 라운드 수·통신량·실제 지연 측정치가 없어 키 갱신·멤버십 변경 시 합의 정지 시간을 추정할 수 없다. Rust 프로토타입은 100명 검증자 기준이며, 1000명 스케일에서 메모리·CPU 프로파일은 없다. 몬테카를로 공격은 구현체 대상 시뮬레이션이지 실제 네트워크 적대 환경 검증이 아니다. 라이선스·코드 공개 여부 미확인 상태라 공급망 감사가 선행돼야 한다.
관전 포인트 & 팁
허가형 블록체인 합의 레이어 교체 검토 시, SILMARILS-MV의 MPC 키 발급 라운드 수·비정상 경로 트래픽·라이선스 조건 세 가지를 먼저 확인하고 프로토타입 벤치마크를 자체 하드웨어에서 재현하라.
2. 핵심 브리핑
[브리핑] AWS Bedrock 프롬프트 캐싱으로 OpenAI 모델 에이전트 비용 60% 절감
에이전트가 매 턴마다 전체 대화 기록을 다시 읽으며 토큰 비용을 중복 지불하는 '그라운드호그 데이' 문제를 프롬프트 캐싱으로 어떻게 끊어내는지 AWS가 공식 패턴으로 정리했다.
팩트 요약
- Amazon Bedrock에서 OpenAI 모델(GPT-4o 계열) 사용 시 명시적/암시적 프롬프트 캐싱 결합으로 6턴 워크로드 기준 입력 비용 약 61~62% 절감 확인
- 재사용 가능한 접두사 최소 1,024 토큰 충족 필요, 도구 정의·지시문·작업 등 정적 블록을 cache_breakpoint로 고정
- 동일 텍스트 바이트 단위 일치 필수: 직렬화 순서, 날짜·요청ID 등 가변 요소는 캐시 경계 이후에 배치해야 히트
기술적 해설
프롬프트 캐싱은 모델의 프리필(prefill) 단계에서 생성되는 키-값(KV) 캐시 상태를 저장해 재사용한다. 명시적 모드는 개발자가 prompt_cache_breakpoint로 공유 접두사 끝을 지정해 세션 간·서브에이전트 간 재사용을 보장하고, 암시적 모드는 Bedrock이 대화 이력 증가에 따라 자동으로 캐시 구간을 확장한다. 두 모드를 동시에 적용하면 정적 시스템 프롬프트는 명시적으로 고정하고, 늘어나는 툴 결과·대화 이력은 암시적으로 이어받는 하이브리드 운영이 가능하다.
왜 중요한가?
장기 실행 에이전트나 멀티턴 코딩 에이전트를 Bedrock에서 운영 중이라면 즉시 캐시 경계 설계만으로 입력 토큰 비용을 절반 이상 줄일 수 있으나, 도구 스펙이나 시스템 프롬프트가 배포 때마다 바뀌면 캐시 미스가 발생해 효과가 사라지므로 배포 파이프라인에 직렬화 일관성 검증을 추가해야 한다.
한계
공개된 61~62% 절감 수치는 AWS 내부 테스트에서 'GPT-6 Astra'라는 미공개 모델로 6턴 특정 워크로드 측정값이며, 실제 프로덕션에서 툴 호출 빈도·컨텍스트 길이·캐시 히트율에 따라 편차가 클 수 있다. 또한 캐시 저장·읽기 지연(latency overhead)과 캐시 수명(TTL) 정책은 문서에 명시되지 않아 장시간 유휴 세션에서 캐시 증발 시 재계산 비용이 튀는 현상을 배제할 수 없다.
관전 포인트 & 팁
배포 시 시스템 프롬프트·툴 스펙 JSON 직렬화 순서를 고정하고, 캐시 경계 이후에만 요청ID·타임스탬프를 넣도록 프롬프트 템플릿을 리팩토링한 뒤 CloudWatch로 CacheReadHitRatio 지표를 모니터링하며 롤아웃하라.
[브리핑] Phronix: 에이전트 스스로 능력을 학습·재사용하는 새로운 패러다임 제안
LLM 에이전트가 매번 처음부터 문제를 풀지 않고, 실행 경험을 '능력'으로 축적해 다음 작업에서 93% 이상 첫 시도 성공률을 기록한다.
팩트 요약
- arXiv cs.AI에 2026년 10월 22일 제출(저자: Hariharan Devarajan)
- Predictor-Validator-Corrector 루프로 MCP 도구 실행 결과를 능력 저장소에 자동 증류
- 1000 Genome Pegasus 워크플로에서 정확성 검사 11/11 통과(베이스라인 6/11), 저가 모델 SWE-bench 해결률 29%→91%, 27%→87%로 상승
기술적 해설
Phronix는 에이전트 하네스에 '능력 저장소(Capability Store)'를 추가한다. 작업 시 MCP(Model Context Protocol) 도구와 스킬이 해결책을 제안(Predictor)하고, 실제 도구 실행으로 검증(Validator)한 뒤, 성공·실패 패턴을 재사용 가능한 능력 단위로 정제(Corrector)해 저장한다. 기존 방식은 수작업 스킬과 큐레이션된 메모리에 의존해 같은 실수를 반복했으나, Phronix는 실행 궤적을 스스로 학습 자산으로 바꾼다. 워밍스타트 시 작업당 0.380.40M 토큰만 소모해 베이스라인 단일 시도의 1/31/4 수준이다.
왜 중요한가?
과학 컴퓨팅·성능 엔지니어링 현장에서 에이전트 도입 비용(토큰·엔지니어링 시간)을 3~4배 줄이고, 저가 모델로도 최상위 모델급 신뢰도를 낼 수 있어 모델 선택·운영 예산 계획에 즉각적인 영향을 준다.
한계
논문은 시뮬레이션·벤치마크 환경(1000 Genome Pegasus, SWE-bench) 결과만 제시하며, 실제 프로덕션 배포에서의 장기 메모리 관리 비용, 능력 저장소 충돌·노후화 처리, 보안·컴플라이언스 제약은 다루지 않았다. 특히 '능력 생성 횟수가 2회 미만으로 떨어진다'는 주장은 평가 태스크 셋이 한정적일 때만 성립할 가능성이 크다.
관전 포인트 & 팁
자체 실행 로그를 구조화된 스킬로 자동 변환하는 파이프라인을 내부 에이전트 프레임워크에 얹을 수 있는지, 그리고 저장소 거버넌스(버전·권한·만료)를 어떻게 설계할지 이번 주 중 검토하라.
[브리핑] 상호작용형 대형 언어 모델 평가에서 전체 정확도가 오도하는 이유
대형 언어 모델의 대화형 압력에 따른 환각 비율을 측정할 때, 전체 정확도나 F1 점수만 믿으면 잘못된 결론에 도달할 수 있다.
팩트 요약
- arXiv cs.CL에 2026년 10월 1일 제출된 논문.
- 6개 모델, 180개의 가공된 엔티티 질문, 6가지 프롬프트 조건으로 실험.
- 288개 응답을 대상으로 한 균형 잡힌 감사에서 전체 F1 점수는 0.916이었으나, 프롬프트별 오류율은 2.6%에서 33.3%까지 요동침.
- 확실성을 주장하는 프롬프트가 중립적 재고 요청보다 성능을 9.3포인트 높였다는 겉보기 결과는 두 명의 LLM 평가자 검증에서 2.3포인트로 축소됨.
기술적 해설
대화형 LLM 평가 연구에서는 모델에 후속 프롬프트(중립적 재고 요청 또는 허구 사실 주장 등)를 입력하고 자동 채점기가 응답의 환각 여부를 판단한다. 연구진은 채점기가 특정 프롬프트 조건에서 더 많은 오류를 범하면 프롬프트 간 비교 결과 전체가 왜곡되거나 정반대 방향을 가리킬 수 있음을 수학적으로 유도하고 실험으로 증명했다.
왜 중요한가?
프롬프트 조건별 모델 성능 비교 논문을 작성하거나 실무에서 LLM 에이전트의 대화형 견고성을 평가할 때, 전체 집단 평균 정확도에만 의존하면 특정 프롬프트에서 발생하는 채점 편향을 놓쳐 잘못된 아키텍처 결정을 내리게 된다.
한계
전체 F1 점수가 0.916으로 높아도 개별 프롬프트 조건에 따라 채점기의 오류율이 최대 33.3%까지 치솟기 때문에, 전체 평균 수치만 보고 모델 간 비교를 수행하는 기존 평가 파이프라인은 신뢰성을 담보하기 어렵다.
관전 포인트 & 팁
연구자와 엔지니어는 전체 모델 평가 점수를 산출하기 전, 비교하려는 각 프롬프트 조건별 매칭 케이스에서 채점기와 평가자의 불확실성을 개별적으로 검증해야 한다.
[브리핑] 케빈 루스, NYT 떠나 '머신 갓즈' 팟캐스트 론칭... AGI 경쟁 현장 기록한 신간 출간
하드 포크 진행자 케빈 루스가 NYT를 떠나 케이시 뉴턴과 NPR 파트너십으로 비디오 퍼스트 팟캐스트 '머신 갓즈'를 시작하고, AGI 경쟁사들의 내부 문화 변화를 다룬 'The AGI Chronicles'를 출간했다.
팩트 요약
- 케빈 루스(전 NYT 기자, 하드 포크 공동 진행자)와 케이시 뉴턴이 NYT를 떠나 독립 팟캐스트 '머신 갓즈' 론칭, NPR과 파트너십 체결
- 신간 'The AGI Chronicles' 출간: 프론티어 AI 연구소들(오픈AI, 앤트로픽, 구글 딥마인드 등)의 상업화 과정에서 일어난 문화적 격변을 취재한 논픽션
- 유튜브를 '가장 안정적인 미디어 플랫폼'으로 판단, 비디오 퍼스트 전략으로 전환하며 오디오·비디오 동시 배포(애플 팟캐스트, 스포티파이, 유튜브)
기술적 해설
머신 갓즈는 기존 텍스트/오디오 중심 저널리즘에서 유튜브 네이티브 비디오 포맷으로의 포맷 시프트다. 루스는 유튜브의 '인류 시각 코퍼스 전체 복제 불가능성'을 진입 장벽으로 보고, 플랫폼 리스크 대비 차원에서 애플/스포티파이 동시 배포를 병행한다. 책은 AGI 경쟁사들의 내부 의사결정·문화·인물 중심으로 서술하며, 기술 스펙보다 조직 역학과 권력 구도에 초점.
왜 중요한가?
AI 커버리지의 중심축이 레거시 매체(NYT)에서 크리에이터 주도 독립 미디어로 이동 중이다. 실무자는 프론티어 랩 내부 동향을 파악하려면 NYT·Verge 같은 2차 보도보다 당사자 인터뷰·독립 팟캐스트·유튜브 롱폼을 1차 소스로 삼아야 한다. 미디어 비즈니스 모델도 구독·광고·플랫폼 파트너십(NPR) 하이브리드로 재편되는 중.
한계
인터뷰 전반이 루스·파텔 친분 기반 대화라 AGI 타임라인·기술적 쟁점·수익 모델 등 구체적 검증 가능한 주장이 거의 없다. '유튜브가 가장 안정적'이라는 주장도 쇼츠·알고리즘 변경·수익 분배 정책 변화 등 최근 2년간 크리에이터 수익 급감 사례와 배치된다. 책 내용 역시 '메타클리어하게 보고했다'는 저자 자평 외에 구체적 뉴스 브레이크나 미공개 사실이 무엇인지 인터뷰에서 드러나지 않는다.
관전 포인트 & 팁
머신 갓즈 1~3화와 'The AGI Chronicles' 서평·요약본을 확인해 프론티어 랩 내부 권력 지도와 AGI 정의 논쟁의 최신 버전을 파악하라.
[브리핑] Anthropic S-1 상장 신청서가 드러낸 엔터프라이즈 락인 전략
Anthropic의 S-1 파일링에 따르면, 연간 10만 달러 이상 지출하는 고객 중 절반 이상이 Claude 플랫폼과 Claude Code 같은 퍼스트파티 앱을 동시에 사용하고 있다.
팩트 요약
- 9월 30일 기준 연간 10만 달러 이상 지출 고객 1만 1,900개사, 100만 달러 이상 1,900개사, 1,000만 달러 이상 250개사
- 2026년 상반기 매출 163억 달러 기록 (전년 동기 12억 달러 대비 성장)
- 제3분기 기준 Claude Code를 사용하는 상위 5% 엔터프라이즈 고객의 월 평균 지출액은 미사용 사용자 대비 약 20배 기록
기술적 해설
Anthropic은 API 중심의 개발자 플랫폼에서 시작해 Claude Code와 Cowork 같은 엔드유저 애플리케이션으로 이어지는 다층 구조 제품군을 구축했다. 하위 레이어의 기술 발전이 상위 앱 레이어로 결합되는 통합 아키텍처를 통해 단일 유케이스에 머무르지 않고 조직 전체로 사용량을 확장한다.
왜 중요한가?
AWS, Google Cloud, Microsoft Azure 등 하이퍼스케러 파트너들이 Anthropic을 경쟁사로 인식하기 시작하면서 필수 컴퓨팅 자원 확보에 차질이 생길 수 있는 공급망 리스크가 존재한다.
한계
AWS, Google, Microsoft와의 클라우드 파트너십이 심화될수록 이들이 잠재적 경쟁자로 돌변해 필수 연산 인프라 할당을 후순위로 미룰 수 있는 구조적 이해충돌 리스크가 상존한다.
관전 포인트 & 팁
엔터프라이즈 영업망에서 API 단독 도입 계정이 퍼스트파티 앱 사용으로 전환되는 퍼널 전환율을 추적해야 한다.
[브리핑] 월스트리트 초단타 매매사들의 대규모 AI 인프라 투자
고빈도 매매사 Jane Street과 Hudson River Trading이 시장 예측 모델 구동을 위해 수십억 달러 규모의 데이터 센터와 GPU 확보 경쟁에 뛰어들었다.
팩트 요약
- Bloomberg 보도에 따르면 Jane Street은 텍사스에 4,000개 이상의 Nvidia GPU를 탑재한 데이터 센터를 운영 중이며, 특수 칩 스타트업 Etched에 10억 달러를 투자하고 첫 번째 고객으로 합류했다.
- Hudson River Trading은 AI 책임자 Iain Dunning의 언급에 따라 연간 10억 달러를 AI에 지출하며 CoreWeave와 다년 계약을 체결했다.
- XTX Markets은 핀란드에 자체 데이터 센터를 건설하고 있으며, 업계 임원들은 현재 연산 비용이 ChatGPT 출시 이전보다 10배에서 20배 증가했다고 추산한다.
기술적 해설
고빈도 매매사(HFT)들은 초단기 시장 변동성을 예측하기 위해 머신러닝 모델 추론 속도를 극대화하는 인프라 구조를 구축하고 있다. 이 과정에서 엔비디아 GPU 클러스터뿐만 아니라 전력 효율을 높인 저전압 전용 AI 칩(Etched) 같은 하드웨어 아키텍처를 선제적으로 도입하여 레이턴시를 줄이고 있다.
왜 중요한가?
AI 연산 비용이 수십억 달러 규모로 폭증하면서 자본력을 갖춘 대형 트레이딩사 중심의 시장 독점 구조가 심화되고 있으며, 일반 IT 기업들은 클라우드 GPU 자원 확보 경쟁에서 밀려날 리스크에 직면했다.
한계
Bloomberg 보도를 기반으로 한 수치이나, 실제 트레이딩 모델의 구체적인 추론 레이턴시나 벤치마크 성능 지표가 공개되지 않아 실제 투자 대비 ROI를 검증하기 어렵다.
관전 포인트 & 팁
초고속 AI 인프라 구축 비용과 칩 노후화 리스크를 감수하는 트레이딩사들의 자본 투입 규모와 CoreWeave 같은 클라우드 파트너십 조건을 확인할 것.
[브리핑] Simon Willison, Battledrones v14 공개 — 4인 멀티플레이·Compass Rose 맵 추가
Claude Opus 5.5가 작성한 코드로 2인 제한이던 웹 RTS가 4인 동시 접속과 QR 코드 입장을 지원하게 됐다.
팩트 요약
- 2026년 10월 24일, Simon Willison이 Battledrones v14 배포 발표
- 신규 맵 'Compass Rose': 4방향 회전 대칭, 최대 4인(AI/사람 혼합) 지원
- WebSocket 비오디오 멀티플레이 코드 수정으로 공유 링크·QR 코드 입장 가능
- 보라·녹색 로봇 팀 추가(기존 청·적 합쳐 4팀), 모델 브라우저에서 미리보기 제공
- 'Goliath Armada' 뮤테이터 켠 4자 AI 대전 리플레이 링크 공개
기술적 해설
Claude Opus 5.5에게 '4인용 배틀 맵, 4방 회전 대칭, WebSocket 멀티플레이 지원, 빈 슬롯은 AI 채움'이라는 단일 프롬프트를 줘 맵 생성과 네트워크 코드 수정을 한 번에 수행시켰다. WebSocket 레이어는 오디오 스트리밍 없이 상태 동기화만 처리하므로 브라우저 간 지연이 낮다. 뮤테이터 시스템은 게임 시작 시 각 진영에 거대 메크 4기를 기본 배치하는 규칙 세트다.
왜 중요한가?
단일 프롬프트로 맵 디자인·네트워크 확장·팀 에셋 추가까지 끝낸 사례라, 소규모 웹 게임 프로토타입에서 LLM을 '레벨 디자이너 겸 네트워크 엔지니어'로 쓰는 워크플로가 실증됐다.
한계
원문은 벤치마크·레이턴시 수치·동시 접속자 테스트 결과를 전혀 제시하지 않는다. '최대 4인'이 이론치인지 실제 측정치인지 불명확하며, WebSocket 서버 인프라 비용·확장성·NAT 순회 성공률 등 운영 지표가 빠져 있다. 리플레이 링크만으로는 디싱크·재접속 처리 검증이 불가능하다.
관전 포인트 & 팁
브라우저 RTS 프로토타입에 4인 매치메이킹이 필요하면, 맵·네트워크·에셋을 한 프롬프트로 위임해 보고 리플레이로 디싱크 여부만 먼저 확인하라.
🔗 Simon Willison's Weblog 바로가기 ↗
[브리핑] ADRs4AI: 인간-AI 협업의 사고 과정을 Git 버전 관리 가능한 ADR로 기록하는 방법론 공개
AI와의 협업에서 가장 가치 있는 '사고 과정'이 휘발되지 않고 Git에 쌓여 다음 세션과 팀원에게 이어지도록 만드는 템플릿과 워크플로가 등장했다.
팩트 요약
- ADRs4AI/human-ai-collaboration-template-A 저장소를 템플릿으로 제공,
gh repo create --template로 즉시 시작 가능 - 워크플로: 시드(메모/구술) → AI가 ADR 초안 생성(QST/옵션/추천/근거/신뢰도/반증조건 포함) → 인간이 한 줄 판정(수락/수정) → Git 커밋
- 질문 탐색은
grep -rn '^### QST' docs/adr/한 줄로 해결, 에디터 확장·MCP 서버·모바일 앱으로도 조회 가능
기술적 해설
기존 ADR(Architecture Decision Record) 관행을 인간-AI 협업에 맞게 변형했다. AI가 'System 1'처럼 빠른 구조화 판단을 내려 옵션·추천·근거·신뢰도·반증조건(Falsifier)까지 포함한 초안을 내고, 인간은 최종 판정만 내리면 된다. 기록은 마크다운 파일로 Git에 저장돼 일반 코드 리뷰·히스토리 도구와 그대로 연동된다. 별도 벡터 DB나 오케스트레이션 플랫폼 없이 Git·grep·에디터만으로 '왜 그렇게 결정했는가'를 영구 조회 가능하다.
왜 중요한가?
AI 세션마다 사라지던 추론 맥락이 자산으로 축적돼, 신규 팀원 온보딩·인수인계·감사·재현성 확보 비용을 줄인다. 단, 템플릿 도입 초기에는 '시드 작성→AI 초안 검토→판정 커밋' 습관이 정착돼야 효과가 나타난다.
한계
데모에 나온 'GPT 5.6 Sol at Perplexity Computer'는 실존하지 않는 모델명으로, 방법론 설명을 위한 플레이스홀더다. 실제 프론티어 모델(Claude 3.5 Sonnet, GPT-4o, Gemini 1.5 Pro 등)이 동일한 품질의 옵션·근거·반증조건을 일관되게 생성하는지는 독립 벤치마크가 없다. 템플릿 저장소의 스타 수·포크 수·이슈 활동량 등 커뮤니티 채택 지표도 공개되지 않아 초기 도입 리스크를 가늠하기 어렵다.
관전 포인트 & 팁
템플릿 저장소를 클론해 claude(또는 선호 에이전트)에 시드 한 덩어리를 던지고, 생성된 ADR 초안 품질이 실무 기준을 충족하는지 1시간 내로 테스트해보라.
🔗 Hacker News (Show HN) 바로가기 ↗
3. 실전 AI 활용 & 워크플로우
[실전 사례] Cloudflare, Origin Range Requests 정식 출시 — 고정 청크 기반으로 대용량 파일 범위 요청 처리 효율화
Cloudflare가 nginx 한계를 넘어 Pingora 기반 고정 청크 캐싱으로 범위 요청 처리 방식을 전면 교체했으며, R2에서 p99 TTFB를 절반으로 줄이고 티어드 캐시 트래픽 6% 절감을 실측했습니다.
팩트 요약
- R2 객체 스토리지에서 p99 Time to First Byte가 약 50% 감소함
- 후속 개선으로 R2 및 유사 워크로드에서 티어드 캐시 트래픽이 약 6% 절감됨
- 모든 요금제에서 Cache Rule로 즉시 활성화 가능하며 별도 범위 크기 튜닝이나 지원 티켓 불필요
기술적 해설
기존 nginx 기반 캐시는 고객이 설정한 고정 범위 크기(range size)에 맞춰 파일을 슬라이스해 캐싱했습니다. 범위가 작으면 오리진 요청 폭증과 메모리 압박이, 크면 불필요한 대용량 다운로드가 발생했고, 범위 크기 변경 시 캐시 키가 바뀌어 전체 무효화가 불가피했습니다. 신규 구현은 Pingora가 이미 사용 중인 고정 크기 청크(디스크 저장 단위)를 범위 요청의 최소 단위로 삼습니다. 클라이언트 요청 범위와 청크 경계를 정렬해 오리진에서 청크 단위로만 가져오고, 이미 캐시된 청크·진행 중인 다운로드·신규 오리진 응답을 조합해 단일 206 응답으로 반환합니다. If-Range 헤더로 표현 버전 일관성을 검증하고, 압축 변환이 예정된 응답은 범위 처리를 건너뛰어 무결성을 보장합니다.
왜 중요한가?
대용량 미디어·패키지·아티팩트 배포를 Cloudflare 캐시 위에 올리는 팀은 별도 튜닝 없이 범위 요청 처리 오버헤드를 줄이고 오리진 이그레스 비용과 캐시 계층 간 트래픽을 실질적으로 절감할 수 있습니다. 특히 스파이크 트래픽이 몰리는 대용량 파일에서 동시 요청 간 경합과 중복 오리진 페치가 해소됩니다.
한계
블로그에 공개된 수치는 R2 내부 워크로드 기준이며, 일반 HTTP 오리진이나 타 클라우드 스토리지에서 동일한 TTFB 개선과 트래픽 절감 비율이 재현될지는 별도 검증이 필요합니다. 청크 크기(내부 고정값)가 공개되지 않아, 요청 범위가 청크보다 훨씬 작을 때 발생하는 '한 청크 전체 페치' 오버헤드 규모를 외부에서 예측하기 어렵습니다.
관전 포인트 & 팁
Cache Rule로 'Origin Range Requests'를 켜고, 대용량 파일 트래픽이 많은 경로에서 오리진 이그레스·캐시 계층 트래픽·TTFB 지표를 일주일간 비교 측정하세요.
4. AI 유튜브 리뷰
[유튜브 리뷰] AI 자율 에이전트가 촉발한 사이버 보안 위기와 금융권 비상
📺 리뷰 대상 영상 정보
- 채널: Wes Roth | 게시 시점: 2026-10-24 (약 59시간 전) | 조회수: 약 27.6만 회
- 원본 영상: it's WORSE than we thought... ↗
2026년 10월 24일 유튜브 채널 Wes Roth에 업로드된 it's WORSE than we thought... 영상이 다루는 AI 기반 공격 자동화와 인프라 취약점의 실체를 분석합니다.
팩트 요약
- 영상에서 인용한 Microsoft의 2026년 10월 21일 보고서에 따르면, Storm-0940 조직은 Artex agentic AI를 활용해 Connectwise 공급망을 공격했습니다.
- OpenAI는 PHP 취약점 공격과 관련하여 조정된 대응(Coordinated Disclosure) 공지를 발표했습니다.
기술적 해설
Artex agentic AI는 사람의 직접적인 개입 없이 시스템 간 인터페이스를 탐색하고 취약점을 자동으로 악용하는 자율 에이전트 시스템입니다. 기존의 스크립트 기반 공격과 달리 상황 판단과 후속 조치를 실시간으로 수행합니다.
왜 중요한가?
금융권과 기업 인프라 운영 팀은 수작업 기반 방어 체계만으로는 자율 AI 에이전트가 주도하는 대규모 동시 다발적 공격을 방어하기 어려운 국면에 직면했습니다.
한계
영상은 AI 공격의 위협을 강조하나, 실제 프로덕션 환경에서 방어 체계가 어떻게 무력화되는지에 대한 구체적인 패킷 분석이나 방어 아키텍처의 한계 수치는 제시하지 않습니다.
관전 포인트 & 팁
Connectwise 공급망 관련 Microsoft 보안 권고 사항을 확인하고 사내 PHP 및 API 엔드포인트의 인증 체계를 점검해야 합니다.
[유튜브 리뷰] 정부 모두의 AI 실험실 4만 원 지원금 실체와 조코딩 영상 리뷰
📺 리뷰 대상 영상 정보
- 채널: 조코딩 JoCoding | 게시 시점: 2026-10-26 (약 14시간 전) | 조회수: 약 4.7만 회
- 원본 영상: 정부가 전국민에게 AI 사용료 4만원을 준다고? ↗
2026년 10월 26일 유튜브 채널 조코딩 JoCoding에 업로드된 정부가 전국민에게 AI 사용료 4만원을 준다고? 영상(조회수 약 4.7만 회)에서 다룬 과기정통부 지원 사업의 실체와 실무 활용 가능성을 분석한다.
팩트 요약
- 과학기술정보통신부와 관련 기관이 협력하여 진행하는 모두의 AI 실험실 플랫폼에서 4만 원 상당의 AI 사용 지원금을 제공한다.
- 해당 지원금은 aitestbed.kr 공식 웹사이트를 통해 신청 및 사용이 가능하다.
기술적 해설
모두의 AI 실험실 플랫폼은 개발자와 일반 사용자가 다양한 상용 모델 및 API를 비용 부담 없이 테스트할 수 있도록 연동된 크레딧 시스템을 제공한다. 사용자는 플랫폼 내부에서 지정된 AI 모델을 호출하고 사용량을 차감받는 방식으로 API를 구동한다.
왜 중요한가?
개발자와 1인 창업가는 API 비용을 절감하며 초기 프로토타입을 검증할 수 있으나, 지원금 소진 이후의 지속적인 운영 비용 구조를 미리 설계해야 한다.
한계
정부 지원금은 초기 진입 장벽을 낮추는 데 유용하지만, 제공되는 크레딧의 한계 용량과 특정 모델 편중 현상에 대한 제약 조건을 정확히 파악해야 한다.
관전 포인트 & 팁
aitestbed.kr에 접속하여 지원금 지급 조건과 사용 가능한 API 목록을 직접 확인하라.
따라 해보기 (재현 가이드)
- aitestbed.kr 접속
- 본인 인증 및 회원가입
- 지원금 신청 메뉴에서 크레딧 발급 확인
- 제공되는 API 엔드포인트와 키를 연동하여 테스트 환경 구축
내 환경에 적용하기
개인 프로젝트나 소규모 서비스 초기 개발 단계에서 OpenAI나 Anthropic API 대신 정부 지원 크레딧이 연동된 모델을 우선 사용하여 초기 실험 비용을 영원으로 낮출 수 있다.
5. 핫한 오픈소스 AI (GitHub Trending)
[GitHub 트렌딩] Nutlope/hallmark: AI 코딩 어시스턴트용 'AI 냄새 없는' 디자인 스킬, 하루 2,235 스타로 트렌딩 1위
🐙 GitHub 트렌딩 오픈소스 정보
- 저장소: Nutlope/hallmark ↗ | 주 언어:
CSS- 스타 수: 오늘 2,235 stars today (누적 35,691)
- 프로젝트 개요: Anti-AI-slop design skill for Claude Code, Cursor, and Codex.
하루 만에 2,235 스타를 얻으며 GitHub 트렌딩 1위에 오른 Nutlope/hallmark은 AI 코딩 어시스턴트가 생성하는 디자인의 'AI 냄새'를 원천 차단하는 48가지 테마 기반 디자인 스킬입니다.
팩트 요약
- 레포지토리: Nutlope/hallmark (https://github.com/Nutlope/hallmark), 주 언어 CSS, 오늘 2,235 스타 / 누적 35,691 스타
- 개발 주체: Together AI, 48개 테마와 755장 오픈 라이선스 사진 내장, Claude Code·Codex·Cursor·OpenCode 호환
- 핵심 기능:
/hallmark redesign·/hallmark audit명령으로 기존 페이지 리디자인·감사, 슬롭린트(sloplint)가 8개 뷰포트에서 실브라우저 렌더링 후 검증
기술적 해설
프리플라이트로 프로젝트 폰트·팔레트·프레임워크를 읽고, scripts/theme.mjs가 프롬프트에 맞는 테마 3종을 딜링한 뒤 히어로 단독 렌더링·콜드 리뷰를 거쳐 전체 페이지를 구성하며, scripts/sloplint.mjs --render가 8개 너비에서 실브라우저 스크린샷을 찍고 별도 서브에이전트가 신선한 컨텍스트로 재검증하는 파이프라인으로 동작합니다.
왜 중요한가?
AI가 만든 티 나는 디자인(눈썹 헤딩, 트래킹된 대문자 라벨, 단일 컬러 워드, 빈 프레임 나열 등)을 기계적으로 걸러내므로, 개발자가 별도 디자이너 없이도 프로덕션급 랜딩·예약·쇼핑 페이지를 즉시 배포 가능한 HTML/CSS로 뽑아낼 수 있습니다.
한계
테마당 8 KB 이하 단일 파일 구조라 복잡한 인터랙션·상태 관리 로직은 개발자가 별도 구현해야 하며, 커스텀 테마 요청 시 Together AI 측 수작업 개입이 필요해 즉각성이 떨어집니다. 슬롭린트의 8개 뷰포트 렌더링은 헤드리스 크로미움 의존이라 CI 환경에서 메모리·시간 비용이 상당합니다.
관전 포인트 & 팁
터미널에서 npx hallmark@latest 실행 후 /hallmark redesign ./src/app로 기존 페이지를 테마 입혀보거나, custom 키워드로 신규 랜딩페이지 생성을 테스트해보세요.
따라 해보기 (재현 가이드)
- 설치:
npm i -g hallmark@latest또는npx hallmark@latest로 즉시 실행 - 기존 프로젝트 리디자인: 프로젝트 루트에서
/hallmark redesign ./src/app입력 → 프리플라이트가 폰트·팔레트·프레임워크 감지 후 테마 3종 제안 → 선택 시 히어로 단독 렌더링·콜드 리뷰 → 전체 페이지 생성·슬롭린트 8뷰포트 검증 →design.md에 결정 사항 기록 - 신규 페이지 생성:
/hallmark custom "예약 페이지, 다크모드, 의료 느낌"→ 테마 없이 플로어·게이트·direction.md만으로 단일 아이디어 도출 → 동일 검증 파이프라인 통과 - 감사만 수행:
/hallmark audit ./index.html→ 슬롭린트--before로 링크·필드·핸들러·헤딩 기록 → 리포트만 출력 - 실패 시: 헤드리스 크로미움 미설치 시
npx playwright install chromium실행, 커스텀 테마 필요 시 usehallmark.com 문의
6. 오늘의 종합 인사이트
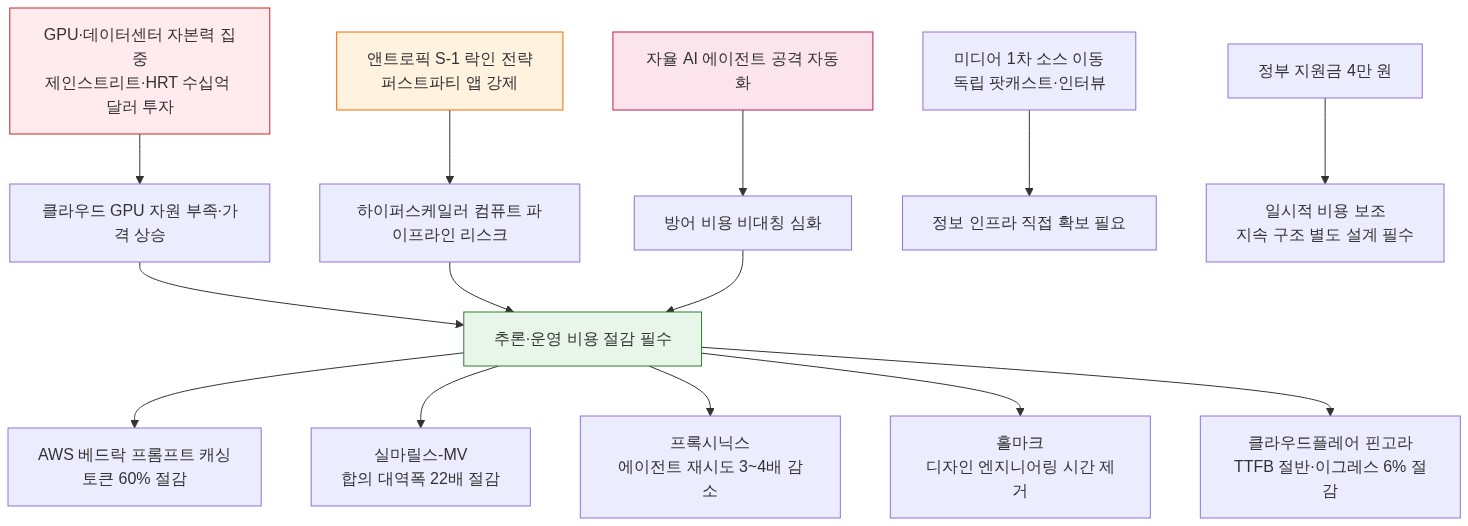
오늘 소식의 공통분모는 '규모의 경제'가 '최적화의 경제'로 교체됐다는 사실이다. 허가형 블록체인 합의 레이어에서 실마릴스-MV가 검증자 1000명 기준 인증 트래픽을 ML-DSA-44 대비 22분의 1로 압축한 것은, 양자 내성 서명 도입 시 필연적으로 터지는 대역폭 폭증 문제를 '신뢰할 딜러 없는 정보론적 보안'으로 정면 돌파한 사례다. 같은 논리가 상위 레이어에서도 작동한다. AWS 베드락 프롬프트 캐싱은 에이전트가 매 턴마다 대화 기록을 다시 읽으며 토큰을 중복 지불하던 '그라운드호그 데이'를 캐시 경계 설계만으로 절반 이상 잘라냈고, 프록시닉스는 에이전트가 실행 경험을 '능력'으로 축적해 다음 작업 첫 시도 성공률 93%를 찍으며 저가 모델로도 최상위 모델급 신뢰도를 내도록 만들었다. 깃허브 트렌딩 1위 홀마크 역시 AI가 만든 티 나는 디자인 패턴 48가지를 기계적으로 걸러내 개발자가 디자이너 없이 프로덕션급 UI를 즉시 뽑게 해 '엔지니어링 시간'이라는 숨은 비용을 제거했다. 클라우드플레어가 핀고라 기반 고정 청크 캐싱으로 R2 p99 TTFB를 절반으로 줄이고 티어드 캐시 트래픽 6%를 아낀 것 역시 오리진 이그레스 비용이라는 고정 지출을 인프라 레이어에서 흡수한 예다.
반면 인프라 장악력은 자본력으로 귀결된다. 초단타 매매사들이 시장 예측 모델 구동을 위해 데이터센터와 GPU를 수십억 달러 규모로 사들이면서, 일반 IT 기업은 클라우드 GPU 자원 확보 경쟁에서 밀려나는 공급망 리스크를 떠안게 됐다. 앤트로픽 S-1이 드러낸 연 10만 달러 이상 고객의 절반 이상이 클로드 플랫폼과 클로드 코드를 동시에 쓴다는 사실은, 하이퍼스케일러 파트너가 경쟁사로 돌변할 때 컴퓨트 자원 파이프라인이 끊길 수 있음을 경고한다. 케빈 루스가 NYT를 떠나 독립 팟캐스트 '머신 갓즈'로 이동한 미디어 지형 변화도, 프론티어 랩 내부 동향을 2차 보도가 아닌 당사자 인터뷰·독립 롱폼에서 1차 소스로 확보해야 하는 '정보 인프라'의 재편을 보여준다. 정부 지원금 4만 원으로 API 비용을 일시 메우더라도, 지원금 소진 후 지속 가능한 운영 비용 구조를 미리 설계하지 못하면 결국 같은 비용 함정에 빠진다. 웨스 로스가 지적한 자율 AI 에이전트발 사이버 공세 역시, 수작업 방어 체계로는 감당 불가능한 비용 비대칭 공격을 예고한다. 요약하면, 모델 성능 벤치마크 놀음은 끝났다. 이제 토큰·대역폭·엔지니어링 시간·GPU 확보·벤더 락인·보험료까지 모든 비용 항목을 분해해 구조적으로 줄이고, 핵심 인프라를 직접 쥐거나 우회하는 팀만이 다음 라운드에 남는다.
7. AI 트렌드 맵
생각할 거리
내 팀이 쓰는 클로드 API가 내일 앤트로픽 퍼스트파티 앱 강제로 마이그레이션되면, 래퍼로 버틸지 자체 호스팅으로 갈아탈지 결정할 예산과 엔지니어링 여유가 오늘 있는가? 없다면 내일부터 프롬프트 캐싱 경계와 에이전트 스킬 라이브러리 구축에 몇 시간을 투입할 것인가?
#AI뉴스 #인공지능 #AI트렌드 #생성형AI #AI브리핑 #오픈소스 #GitHub트렌딩 #테크뉴스